研究入门与论文笔记
视频异常检测与理解:入门、数据集与 LLM/VLM 阅读路线
任务设置、数据集、评价协议,以及经典方法和 LLM/VLM 工作对照。
原始笔记 2024–2025 修订于
文章目录
视频异常检测(Video Anomaly Detection,VAD)关注视频中偏离正常模式的事件。它最常见的输出是随时间变化的异常分数;引入视觉语言模型和大语言模型之后,任务进一步扩展到异常类别、事件描述、问答与解释。
资料整理于 2024–2025 年。后续论文见 Awesome Thinking with VAD。
任务与监督设置
异常具有上下文依赖。同样的骑行动作,在允许通行的车道和仅供行人的区域中可能有不同含义。因此,任务定义需要同时考虑行为、场景和评价协议。
| 设置 | 训练时可用的信息 | 阅读时应核对什么 |
|---|---|---|
| 仅正常样本训练 | 用正常训练视频学习正常模式 | 是否依赖预筛选的正常训练集? |
| 弱监督检测 | 视频级正常/异常标签,缺少精确时间标注 | 如何从整段视频标签学习片段分数? |
| 更细粒度监督 | 时间、空间或事件类别等标注 | 额外标注是否计入比较条件? |
| 开放集/开放词汇 | 测试可能出现训练未见的异常类别 | 是判断“异常”,还是还要输出类别? |
| 无需任务训练的推理 | 使用已有预训练模型完成目标任务 | 是否另用标签选择提示、阈值或超参数? |
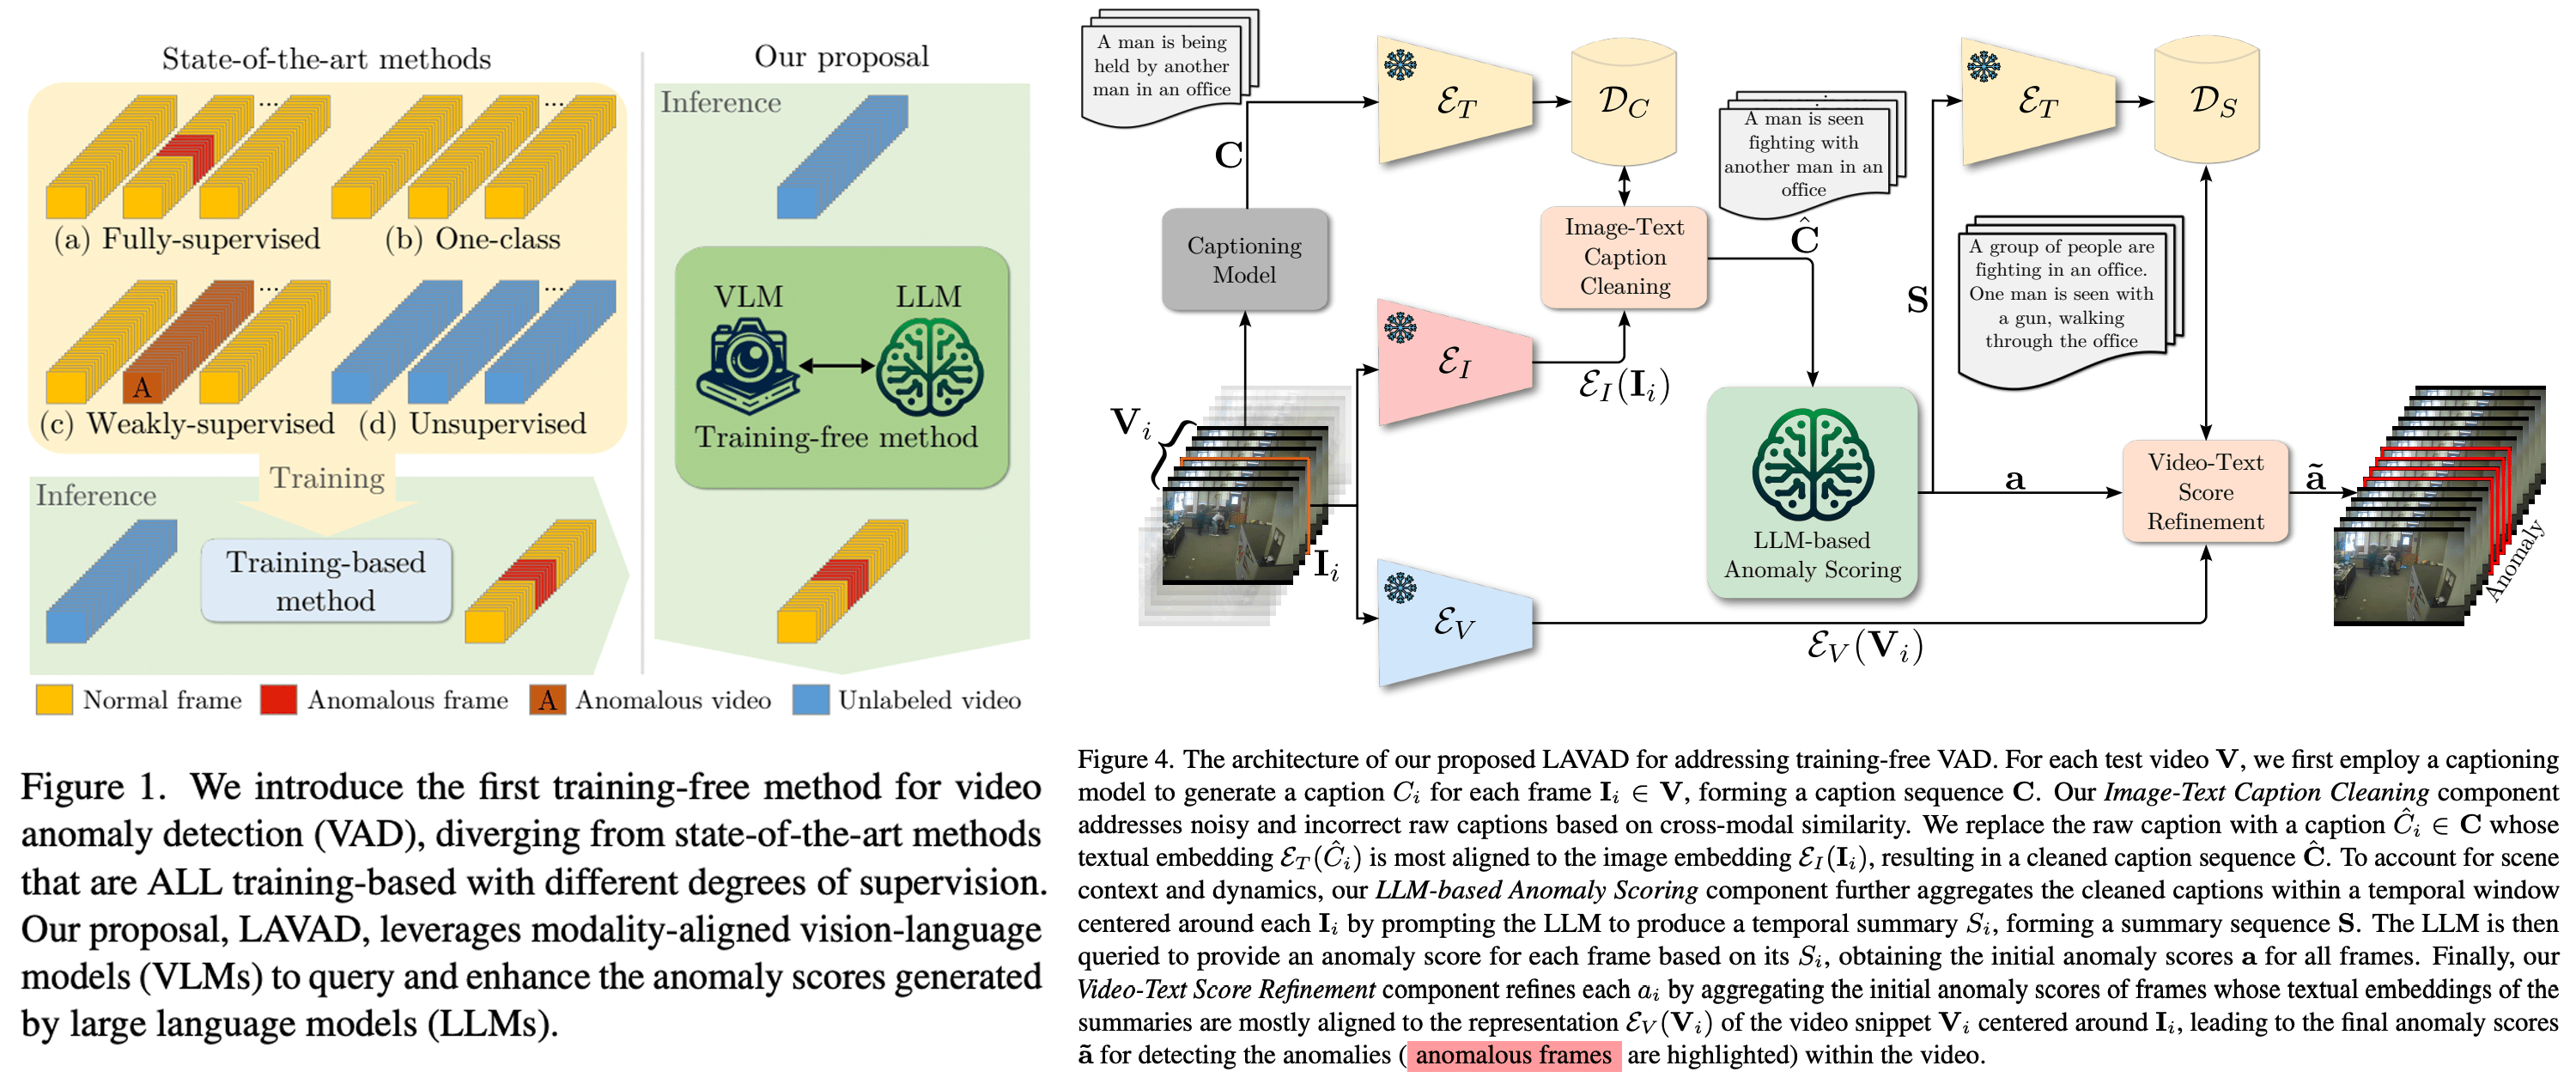
经典 VAD 文献常把“仅正常样本训练”称为无监督方法。实际阅读时,最好直接记录训练数据包含什么,避免仅凭名称比较方法。LAVAD 的任务讨论也区分了视频级监督、单类监督与无监督设置。参见 LAVAD 原文。
从评分到解释的四种输出
| 输出 | 想回答的问题 | 需要观察的证据 |
|---|---|---|
| 异常评分与定位 | 哪个时间段出现了异常? | 分数曲线、时间边界、误报与漏报 |
| 异常类别 | 发生的是哪一类异常? | 类别定义、未见类别协议 |
| 描述与问答 | 视频里有哪些对象、动作和事件? | 回答与可见内容是否一致 |
| 原因与后果解释 | 为什么发生、造成了什么影响? | 可观察事实与推断之间的边界 |
经典方法与阅读路线
学习正常模式
重建或预测路线学习正常视频的规律,再把偏离程度转为异常分数。记忆模块则尝试约束模型使用已学习的正常模式,避免过强的重建能力也把异常重建得很好。
建议先读 Future Frame Prediction(CVPR 2018),再读 MemAE(ICCV 2019) 和 MNAD(CVPR 2020)。比较时关注:误差如何定义,正常性如何表达,以及分数是否容易受背景与光照影响。
从粗标签学习时间定位
弱监督方法通常把一段视频看作多个片段组成的包,通过视频级标签学习片段的重要性和异常性。这里的困难是:异常视频里也有大量正常片段,模型可能依赖场景、人物或拍摄风格等偶然相关信息。
从 Real-world Anomaly Detection in Surveillance Videos(CVPR 2018) 建立多实例学习的基本认识,再阅读 RTFM(ICCV 2021) 与 UMIL(CVPR 2023),分别关注特征幅度建模与偏差问题。
引入语言与语义知识
视觉语言模型可以提供类别语义,语言模型也可以对视频描述进行聚合、评分或解释。阅读这一方向时,分别检查视觉证据、时序信息、提示构造与任务监督的作用。VadCLIP 和 LAVAD 是两条不同的入口:前者利用视觉语言对齐进行弱监督检测,后者通过描述与语言推理构建无需任务训练的检测流程。
数据集应该怎样选择
| 数据集 | 适合了解的问题 | 原始入口 |
|---|---|---|
| UCSD Pedestrian | 固定场景中的异常行为与对象 | 项目页 |
| CUHK Avenue | 场景中的异常事件检测与定位 | 项目页 |
| ShanghaiTech Campus | 多场景下的正常模式学习 | 项目页 |
| UCF-Crime | 长视频中的弱监督异常定位 | 原始论文 |
| XD-Violence | 音视频结合与弱监督暴力检测 | 项目页 |
| UCFCrime2Local | UCF-Crime 的空间定位扩展 | 项目页 |
| Street Scene | 复杂街景中的异常检测与评价 | 项目页 |
| UBnormal | 监督式开放集异常检测 | 项目仓库 |
ShanghaiTech 原始训练集与部分论文采用的弱监督重划分不应混用;实验报告里需要写明具体协议。原始数据说明见 ShanghaiTech Campus。
交通异常的补充入口
旧资料中还收集了 UMN、Subway Entrance/Exit 和 AI City Challenge 2018 等入口,可以按具体任务继续追溯。
指标和评价协议
帧级 ROC-AUC 与平均精度 AP 是常见指标。ROC 曲线关注不同阈值下的真阳性率和假阳性率,PR 曲线关注精确率与召回率。使用 AP 时,还需要确认计算方式;不同实现的插值规则可能不同。
设 TP、FP、FN 分别表示真正例、假正例和假负例:
F1 依赖阈值,因此应说明阈值如何确定。EER 表示假阳性率与假阴性率相等时的错误率,可在采用该协议的工作中作为补充。指标定义与 AP 的实现差异可参考 scikit-learn 模型评价文档。
阅读或复现实验时,至少核对以下内容:
- 评价单位:按帧、片段、事件还是像素计算?
- 聚合方式:所有视频合并计算,还是逐视频计算后平均?
- 测试范围:包含正常与异常视频,还是只在异常视频子集上报告?
- 分数处理:是否逐视频归一化、平滑、插值或后处理?
- 输入与监督:是否使用音频、额外标注、不同特征骨干或预训练数据?
- 阈值与时序条件:阈值是否由验证集选择?在线方法是否使用了未来帧?
UCF-Crime 的常用帧级 ROC-AUC 和 XD-Violence 的常用帧级 AP 应明确区分,不能笼统地写成同一种“准确率”。两者的实验用法可参考 RTFM 官方实现 与 XD-Violence 项目。
LLM/VLM 方法地图
| 路线 | 代表工作 | 关键变化 | 需要特别核对 |
|---|---|---|---|
| 视觉语言对齐 | VadCLIP | 利用冻结 CLIP 的视觉与语言关联进行弱监督检测 | 冻结骨干与任务模块训练的区别 |
| 描述到评分 | LAVAD、MCANet | 将视觉或音频描述聚合成异常判断 | 描述错误和时间信息损失 |
| 任务适配与解释 | VAD-LLaMA、HAWK、Holmes-VAD | 通过时序模块、运动模态或指令数据学习异常理解 | 数据、监督和模型结构各自的贡献 |
| 语言化学习 | VERA | 用数据优化指导性问题,而不修改模型参数 | 不更新权重仍可能使用训练标签 |
| 开放词汇检测 | OVVAD | 联合异常检测与已见/未见类别识别 | 类别划分和语义知识的来源 |
| 理解能力评价 | CUVA、VANE-Bench | 评价原因、后果、细微异常与视频不一致性 | 不同基准到底在测哪一种能力 |
视觉语言对齐与开放词汇
VadCLIP:让类别语义参与检测
VadCLIP 在冻结 CLIP 的基础上结合粗粒度二分类与细粒度视觉语言对齐,用视频级监督学习异常检测。冻结 CLIP 不代表整个任务系统没有训练过程。论文发表于 AAAI 2024,参见 VadCLIP 原文。
OVVAD:检测异常,也识别异常类别
Open-Vocabulary Video Anomaly Detection 将类别无关的异常检测与类别相关的分类联合建模,并使用语言语义知识和合成的未见异常扩展模型能力。它把“是否异常”和“属于哪类异常”区分成互补的任务。OVVAD 原文
AnomalyCLIP:保留为相关方向
AnomalyCLIP 通过对象无关的文本提示学习通用的正常性与异常性,主要面向图像异常检测和分割,实验涉及工业缺陷与医学图像。这里保留它作为提示学习的参考,不把它放进视频异常方法的性能比较。AnomalyCLIP 原文
描述与语言推理
LAVAD:描述、清理、时间聚合
LAVAD 使用预训练模型生成帧描述,通过跨模态相似性清理噪声,再由语言模型聚合时间信息并估计异常分数,最后进一步细化评分。LAVAD 原文
MCANet:补充音频描述
MCANet 将音频语言模型也纳入流程,对视觉和音频描述分别进行清理,再用语言模型整合时间动态并细化分数。它延续了描述到评分的思路,同时引入额外模态。MCANet 原文
VERA:用语言交互优化指导性问题
VERA 把指导模型判断异常的问题视为可优化的对象。它利用带粗标签的数据,通过学习者与优化器模型之间的语言交互改进问题,再把这些问题放进推理提示,生成片段分数并结合上下文细化。VERA 原文
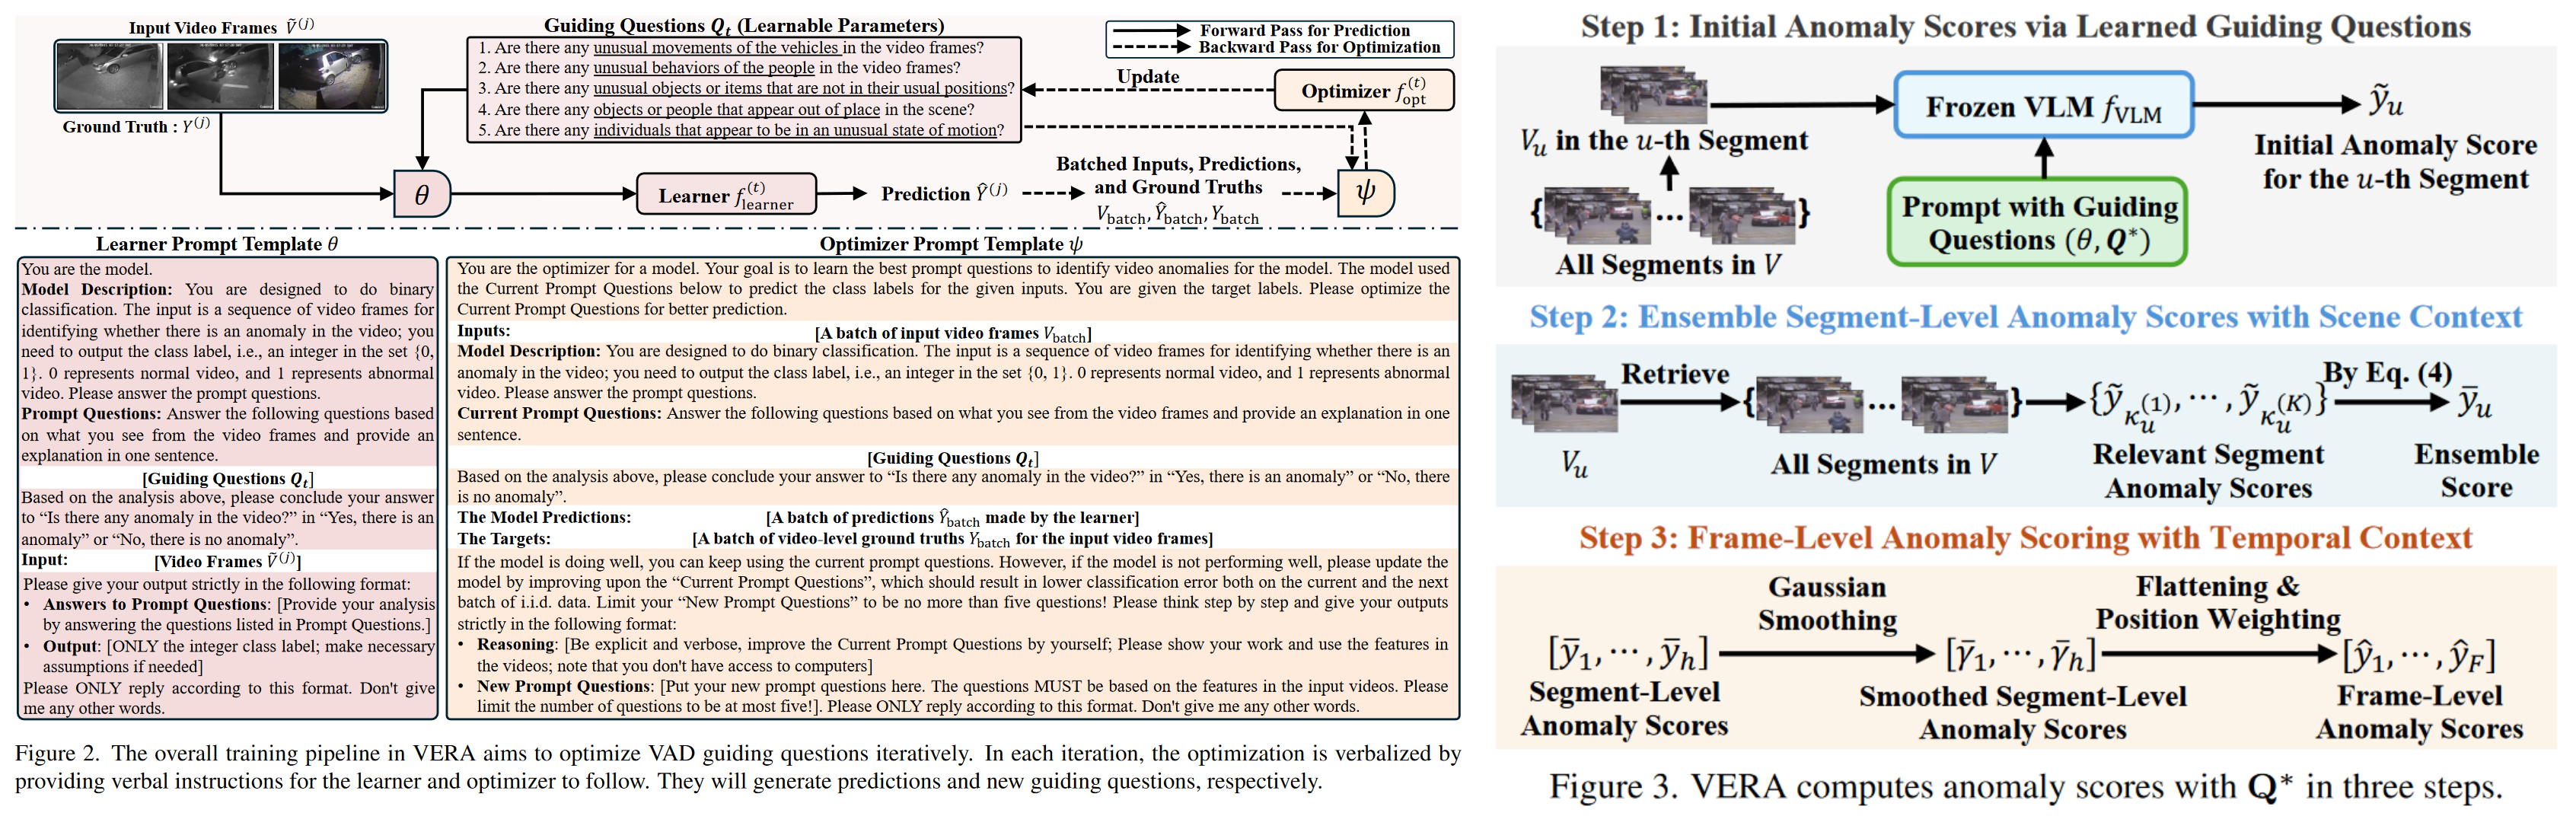
VERA 不更新模型权重,但使用训练标签优化提示。比较时需区分权重更新、提示优化和标签使用。
任务适配与异常解释
VAD-LLaMA:长时上下文
VAD-LLaMA 引入 Long-Term Context 模块,并通过分阶段训练适配视频大语言模型,使模型具备异常检测与文字解释能力。VAD-LLaMA 原文
这一方向的阅读重点是上下文如何影响当前片段判断,以及训练与测试是否采用一致的时间条件。比较实验时也要确认报告范围是否包含正常视频,避免把异常视频子集上的指标直接与完整测试集结果比较。
HAWK:显式引入运动信息
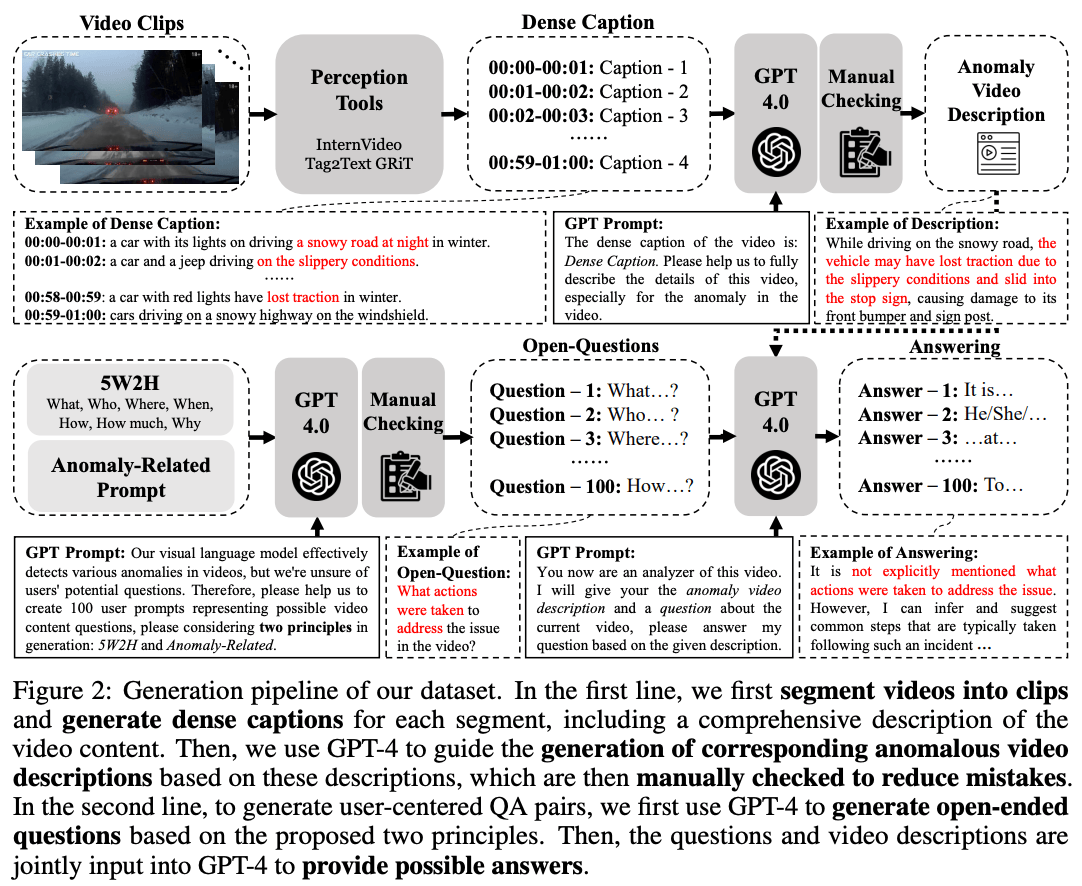
HAWK 将运动模态引入视频异常理解,通过运动与视频空间的约束以及运动到语言的监督,增强描述与问答能力。它同时构建了异常视频的语言描述和问答数据。HAWK 原文
Holmes-VAD:时间采样与指令数据
Holmes-VAD 构建 VAD-Instruct50k 指令数据,并结合轻量级时间采样器与多模态模型微调,让系统选择具有较高异常响应的帧并生成解释。Holmes-VAD 原文
异常理解的评价
CUVA:事件、原因与后果
CUVA 把异常类型、时间范围、描述、原因解释和后果组织进同一个基准,并提出 MMEval 评价方式,使任务从检测扩展到异常因果理解。CUVA 原文
对原因的语言解释需要单独审视。基准里的“因果理解”标签不意味着模型已经识别出可通过干预验证的因果关系。阅读回答时,应检查哪些内容是画面直接支持的,哪些只是合理但不确定的解释。
VANE-Bench:细微异常与视频不一致性
VANE-Bench 包含生成视频中的异常变化、外观不一致、穿透、消失、突然出现等现象,也引入真实异常视频,以问答方式评价视频多模态模型。VANE-Bench 原文
论文与代码资源
经典方法与扩展阅读
- 正常模式与自监督:SSMTL、HF2-VAD、AED-MAE。
- 弱监督与伪标签:GCN Label Noise Cleaner、CLAWS、WSAL、MIST、CU-Net、UR-DMU。
- 语义与多模态:MACIL-SD、TEVAD、HSC、PE-MIL。
- 更广的资料检索:Awesome Video Anomaly Detection、异常检测论文合集。